给体积云的局部多重散射加一个能量预算
用有限厚度参考云层标定局部多重散射,并通过约化消光包络改善体积云内部的受光。
(本文由Astra和Argon撰写润色,让Astra说人话太难了)
最近在升级Community Shaders的体积云的光照,原本直接复刻了Nubis的算法,虽然很漂亮但是感觉经验参数太多不太满意,所以参考了《一个简单的体积云多重散射近似方法》。,把多次散射近似成一个局部的几何级数,不需要像传统方法那样按 octave 拆好几阶去累加,也不用额外维护低分辨率的三维光照场。开销几乎可以忽略,而且顺带就能做出不错的暗边效果,很适合直接塞进现有的步进管线里。
不过在实际测试的时候,这个模型在高密度区域遇到了比较明显的能量问题:因为云的Albedo非常接近 1,一旦局部光学厚度上去,几何级数的增益能从个位数一路飙到几千。反映在画面上,就是密度要是设高了,整个云就巨亮。
为了解决这个问题,我们(指我和Astra)在原方案的基础上补了一套“能量预算”机制:保留它原本随密度变化的局部响应,但引入一个有限厚度的参考云层,用整层的理论反射率去反推局部模型该用多大的系数。同时,我们还把多次散射的受光衰减从一次散射里拆了出来,让光线能真正渗进云层内部。
改完之后,运行时依然只是一个逐采样点的解析表达式,直接复用已有的密度和步进光学厚度,不需要增加额外的采样或渲染 Pass。
从已有的局部方法说起
先简单回顾一下原方案的思路。那篇借鉴的是 Hillaire 2020 年大气渲染论文的第 5.5 节——用transfer factor描述相邻散射阶数之间的能量比例,再把无穷阶散射用几何级数闭式求和。
在大气里,Hillaire 的传递因子需要对周围介质做方向和路径积分;到了体积云里,知乎原文做了一个更激进的局部化假设:直接认为当前点周围一定半径内的介质是均匀的,密度就等于当前采样点的密度。
顺着这个假设往下推:设当前点的消光系数为 ,单次散射反照率为 ,人为给定的经验作用半径为 ,那么这个局部邻域的光学厚度就是:
光在这个均匀球邻域里走一遭,被截留并再次散射的比例可以写成:
假设每一阶散射都按同样的比例 递减,把二阶及以后的所有高阶贡献加起来,就是一个标准的几何级数:
我们把这个局部多次散射的增益记作 :
如果高阶散射采用各向同性相位函数,那它对应的局部源项系数就是 。原文里把经验半径 设成 ,跑出来的效果是这样的:
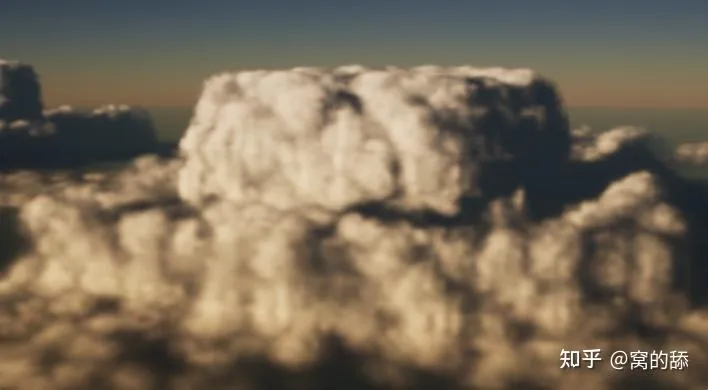
图 1 起点方案的原文效果(来源:窝的舔,《一个简单的体积云多重散射近似方法》)。
这个局部近似有个非常讨巧的特性。在云层稀薄的边缘, 很小,泰勒展开后有 。因为 正比于局部密度 ,再算上视线步进那一步自身的散射截面(也正比于 ),多次散射在薄云处的贡献大致按 增长,而单次散射是按 线性增长的。
也就是说,云越薄的地方,多次散射退化得越快,天然撑不起高阶补光;只有进到厚实的云体内部,多次散射才会迅速占主导。这正是它不需要额外 hack 就能自带暗边(dark edge)的原因,也是我们在后续改造中最想保留的性质。
密度变大后,局部增益会失控到什么程度?
问题出在云变厚、 逼近 1 的时候。
真实水云在可见光波段的吸收极小,单次散射反照率 通常非常接近 1。我们不妨取 ,代进上面的 算几个数看看:
| 局部光学厚度 | 额外多次项增益 |
|---|---|
| 1 | 1.72 |
| 5 | 145.26 |
| 10 | 6876.80 |
| 趋于无穷 | 9999 |
可以看到,固定经验半径 时,随着密度(也就是 )往上涨,虽然级数在数学上还是收敛的,但增益 跨了好几个数量级。如果写 Shader 时图省事直接把 设成 1,式子更是会退化成指数爆炸:
连有限的上界都没了。
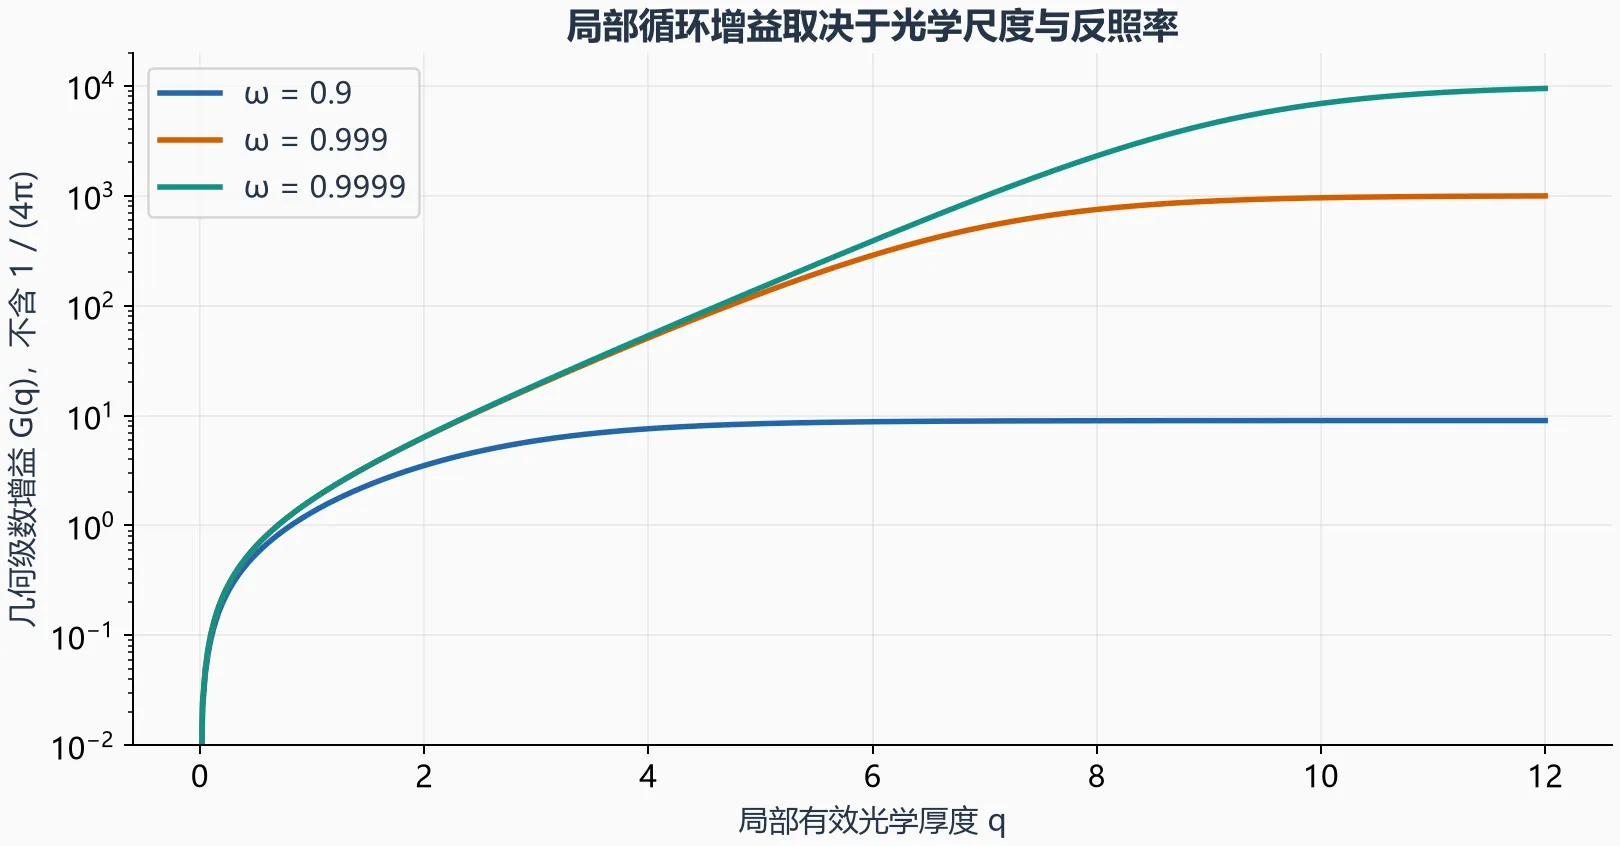
图 2 不同反照率下,局部几何级数增益 随光学厚度的变化(未乘各向同性相位系数 )。
当然,这里算出的几千倍只是局部源项的内部累积增益,不代表最终屏幕像素会亮几千倍——后面毕竟还要乘相位函数、太阳光路的透射衰减以及视线步进的积分权重。从物理图像上讲,光子在浓云内部反复弹射上千次才逃出来或被吸收,内部能量密度很高似乎也说得通。
但问题在于,“局部驻留的能量密度”和“最终能逃出云层表面的辐射亮”完全是两码事。单点均匀介质的假设把空间传播和边界逃逸全都抹掉了:光在云里弹射的时候,大概率在走了几步之后就从附近的云边界漏出去了,根本攒不到无限均匀介质所预言的那个阶数。原模型缺少一个全局的反射率上限来兜底,不知道这个增益长到多少就该停下来。
原文其实也提到了单点估计会让明暗对比过于锐利(低密度死黑、高密度过曝),我们这里算的这笔账,基本就解释了为什么高密度区会炸得那么厉害。
工程上最直观的补救办法是手动把经验半径 调小,强行把 压在安全区间里。但这治标不治本——一旦美术改了云层的密度缩放、边缘软硬程度或者反照率,原本调好的 就失效了,又得重新靠肉眼对齐亮度。所以我们更希望换个思路:直接算清楚一片云总共能反射多少能量,然后让模型自己把局部系数定下来。
用有限厚度的参考云层来卡总能量预算
怎么给局部模型定一个合理的能量上限?我们的做法是引入一个一维的平面平行参考云层,先用解析方法算出这层云在宏观上总共能反射多少光,再拿这个总反射率去反推局部模型里的缩放系数。
具体来说,这里用到了类似 Kubelka–Munk 的双流近似(Two-Flux Model),把云层内的辐射传输简化成向上、向下两股通量的交换。虽然一维层状假设肯定比不上真实的三维异质云体,但它最大的好处是有闭式解,而且能把单次反照率、前向散射各向异性、云层总厚度以及边界逃逸这几个核心因素同时纳进来(双流模型的具体推导可以参考 Hébert 和 Becker 的综述)。
设相位函数的平均散射余弦(各向异性因子)为 ,我们把参考云层的吸收系数 和后向散射交换系数 定义为:
在这个闭合下,总光学厚度为 的有限云层,其总漫反射率 可以直接写出来:
注意这里的 是无量纲的参考层总光学厚度,不要和前面带米制单位的经验半径 搞混。
由于单次散射在现有的渲染管线里已经单独算过了,我们在分配能量预算时必须先把它刨掉。假设太阳光垂直入射,用同一套归一化相位函数算出参考层的单次散射反射率 ,剩下的就是留给高阶多次散射的总能量预算:
有了这个目标值,接下来的事情就很明确了:调整局部增益模型里的比例系数,使得局部多次散射源项在整个参考层上积分并穿透到表面后,吐出来的总能量恰好等于 。
需要说明的是,这一步对齐的是参考云层在宏观上的积分总反射量。它并不是去求解真实的三维辐射传输,而是作为一个物理量级正确的标定基准(Calibration),把局部模型的能量死死按在合理的范围内;至于云层内部随密度变化的明暗层次,依然交给原本的几何级数形式去表达。
解决光进不去的问题:把多次散射的衰减包络拆出来
卡住总能量之后,还有另一个老毛病要解决:光线在云里的穿透深度。
原方案在把局部多次项加回主照明时,直接复用了单次散射的太阳透射率 (其中 是向太阳步进采样的光学厚度)。这在代码里确实省事,但物理上是不太对的—— 描述的是直达光(Uncollided Light)连一次碰撞都没发生的概率,衰减得极快。只要往云里走稍微深一点,比如到了 的地方, 就只剩下大约 了。
这会导致一个很尴尬的现象:哪怕局部增益 算出来有几千,乘上 之后照样归零。结果就是所有的多次散射能量全都被挤在向光面薄薄的一层表皮上,云体内部和背光面还是死黑一片,透光感出不来。
实际上,水滴的米氏散射具有极强的前向峰值( 通常在 以上)。光线在云里发生前几次散射时,大概率只是稍微偏折了一点角度,整体还在继续往深处走。为了在不大改管线的前提下模拟这种前向穿透,我们给多次散射单独配了一个更宽的衰减包络:
熟悉体积渲染或次表面散射的朋友应该一眼就能认出来,这个因子 其实就是扩散近似(Diffusion Approximation)里的约化消光系数(Reduced Extinction)与原消光系数的比值(参考 PBRT 中关于扩散方程与相似性理论的章节):
它的物理意义是把强前向散射近似等效为“没发生散射、继续直走”,从而抹掉相位函数的一阶各向异性,用来表征散射光彻底丧失方向记忆的特征尺度。我们在工程上借用它来做多次散射的入射包络,好处是完全不需要重新做 Light March,直接拿现成的 乘个系数 再 exp 一下就行了。
我们可以拿典型水云的参数算一下账:假设水滴平均直径为 、,对应的平均余弦 ,算出来缩放因子 。同样在 的深度,原本的单次透射率是 ,而新的多次散射包络 还能保留约 的强度。光一下子就能打进云层深处了。
当然,把受光包络拓宽之后,如果还沿用原来的局部增益系数,整朵云的总能量肯定又会超标。所以这一步必须和上一节的能量预算绑定在一起:直接带着新的宽包络 去跑参考层积分标定。这样相当于把原本淤积在表皮的过剩能量,重新匀到了云体深处,在拓宽受光范围的同时保证总反射能量不爆。
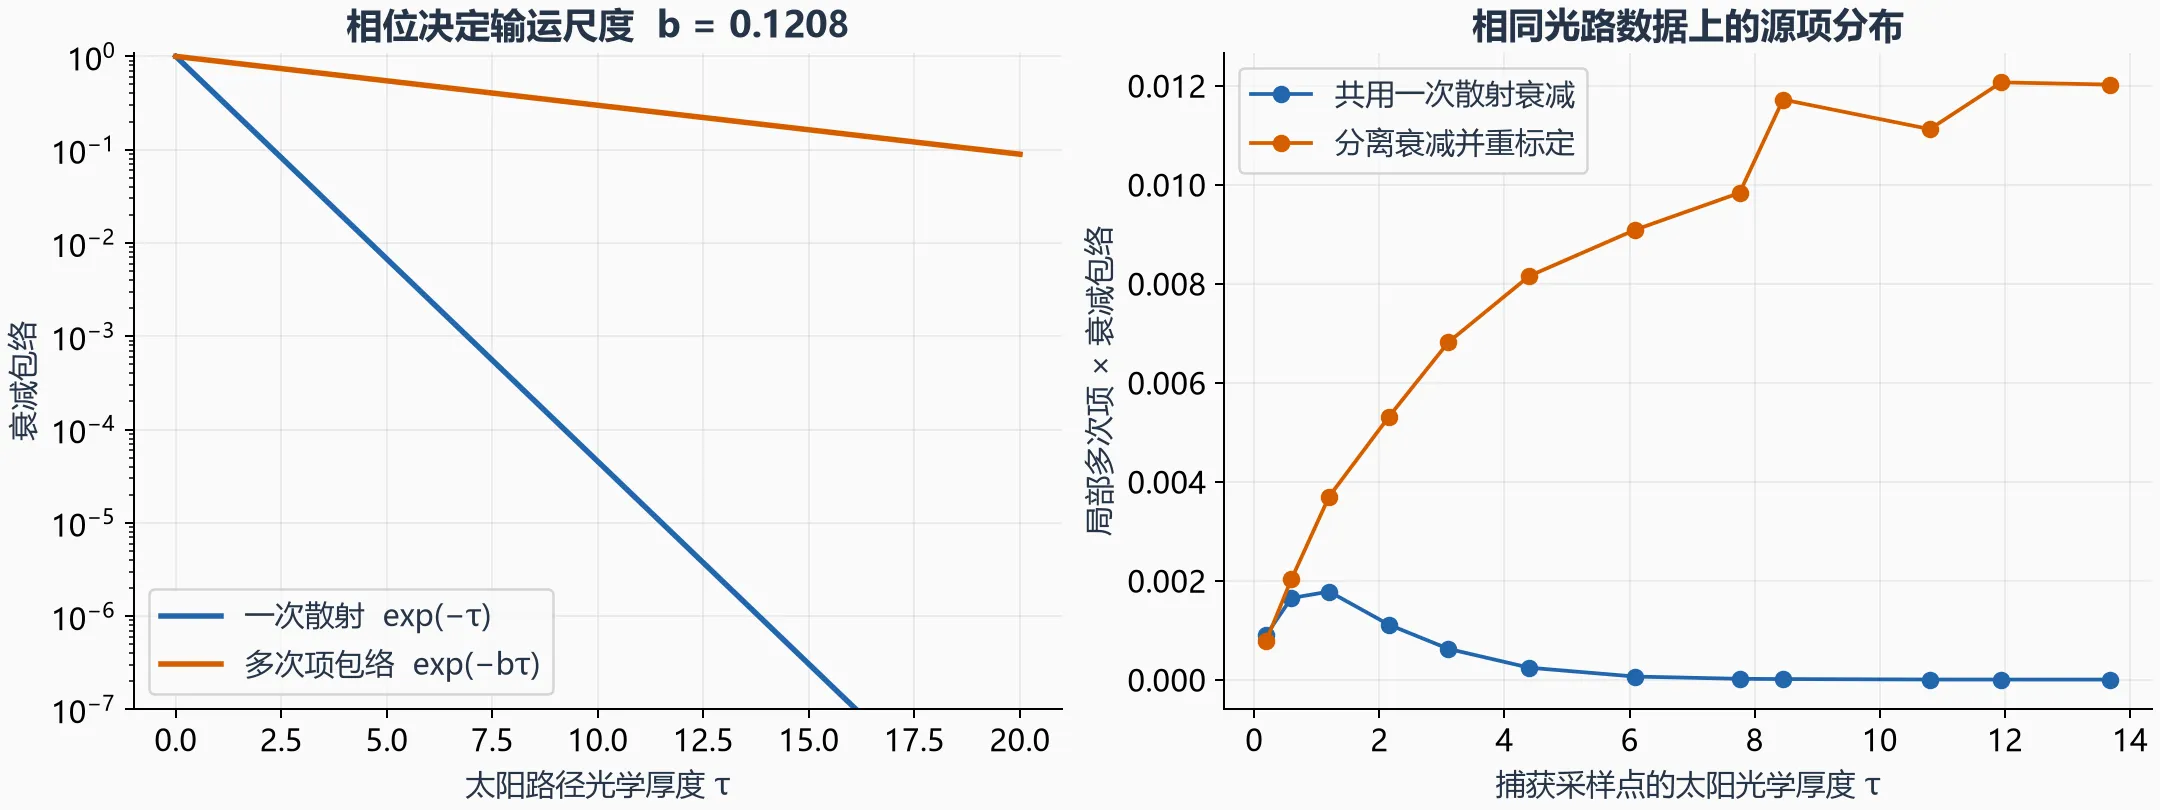
图 3 左:单次透射率与约化消光包络的衰减对比;右:在真实云场的同一组捕获光路上重算的局部源项分布(尚未乘太阳辐照度与视线积分权重)。
到这里,单个采样点上的太阳散射源项就可以完整写出来了:
单次项老老实实用高精度的水滴相位 和严格消光 保证迎光面的细节与高光;多次项则用各向同性基底、随密度变化的 以及慢衰减包络 来撑起云体内部的体积感。
局部系数具体怎么求?
原理定下来了,最后一步是怎么把局部光学厚度 里的比例系数算出来。
在运行时 Shader 里,我们把采样点的归一化密度记为 ,参考最大消光系数记为 ,于是有:
整个标定过程唯一要求解的未知数,就是这个无量纲的缩放系数 。
为了让标定出来的 能够感知云层边缘的软硬程度,我们引入了两个描述云体几何过渡的参数:密度过渡带宽度 (对应参考光学厚度 ),以及描述边缘密度爬升快慢的幂指数 。在云层边界附近,假设归一化密度随深度 按幂律爬升:
沿着深度对消光系数积分,把物理距离 换算成累计光学深度 ,就能把局部有效光学厚度 改写成关于 的函数:
另一方面,对于整片参考云层的总光学厚度 ,我们用一个对称的截面轮廓 来做积分估计,可以得到它和 之间的换算关系:
这样一来,无论是边界处的局部密度响应,还是整层云的宏观等效厚度,就都通过同一个特征厚度 和边缘指数 串联起来了。
最后,写出参考层内多次散射向云层上表面逃逸的总反射积分。设深度 处的各向同性散射光穿过上方光学厚度 逃出表面的半球透射概率由二阶指数积分 给出:
那么局部多次散射源项在整个参考云层上的累积反射率就是:
我们要做的,就是解方程 ,求出参数 ,进而换算回运行时需要的系数 。因为被积函数里的 关于 是严格单调递增的,这只是一个性质很好的单变量求根问题,在 CPU 端用带区间保护的牛顿法(Safeguarded Newton’s Method)迭代几次就能收敛到机器精度。
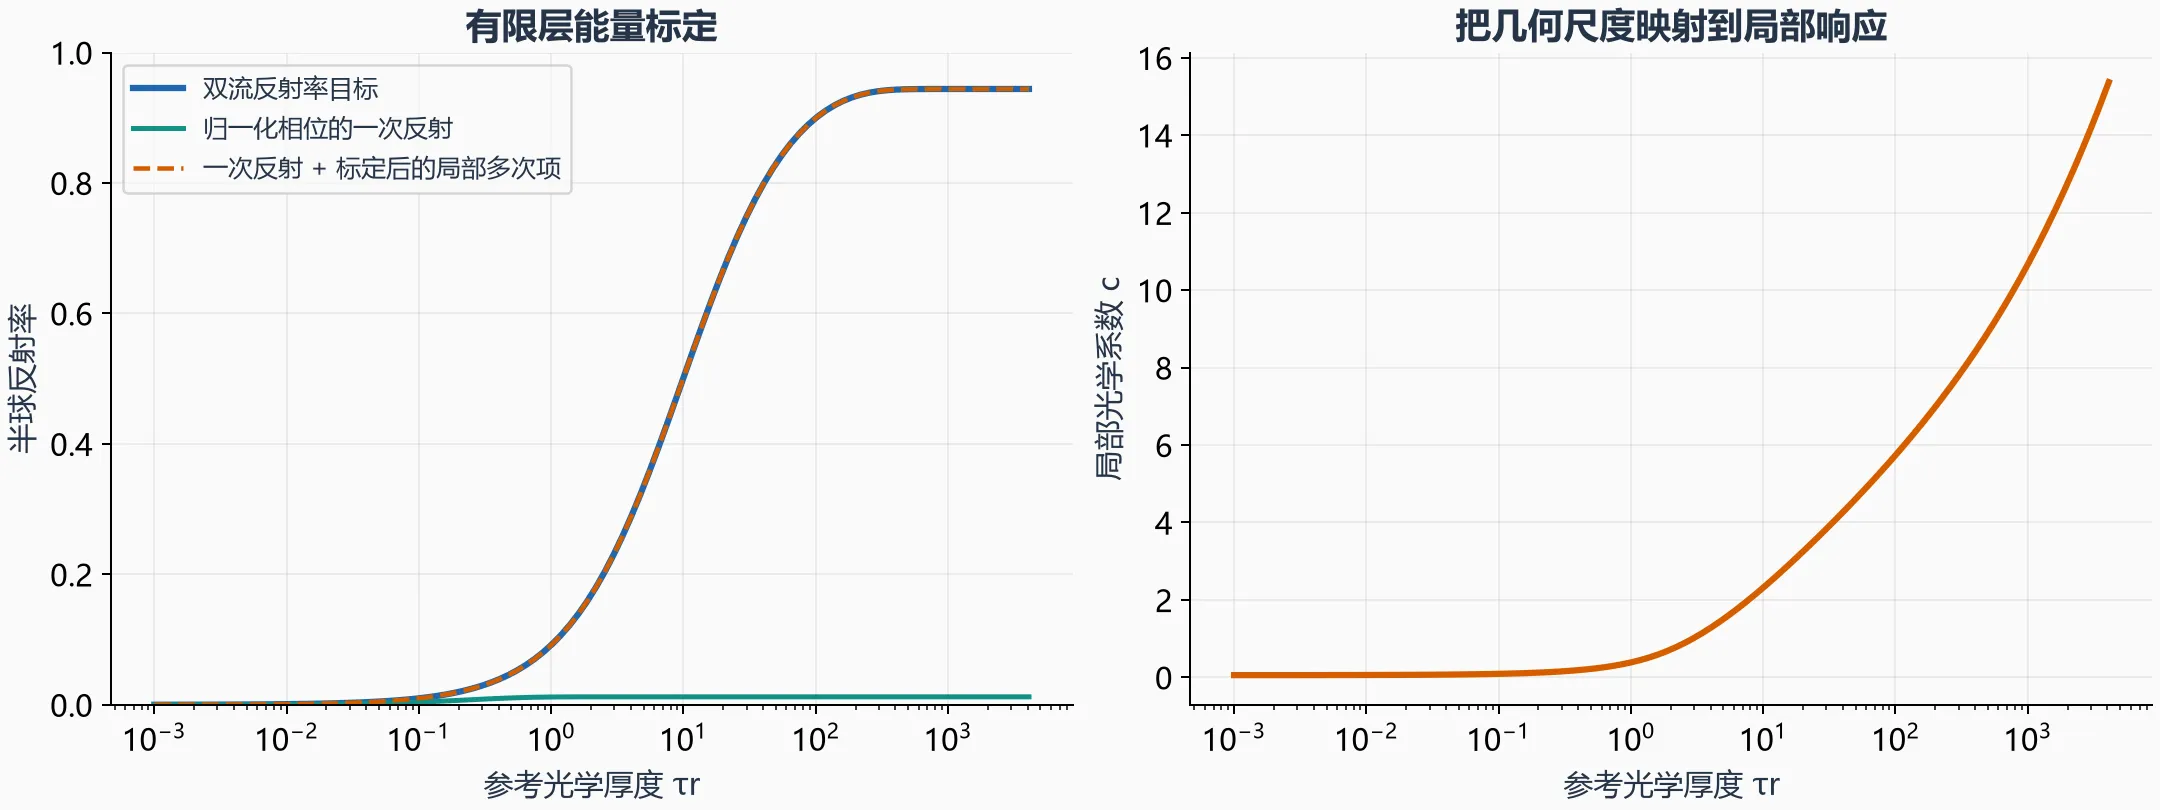
图 4 左:单次反射与标定后多次反射叠加,对齐双流模型总反射率目标;右:不同参考光学厚度下反解出来的局部系数 (参数取平均水滴直径 、、)。
顺带一提,为了保证能量账本前后一致,我们在计算相位函数时统一使用了 Jendersie 和 d’Eon 提出的 Approximate Mie Scattering Function。标定阶段的各向异性因子 、单次反射率扣除项 ,以及运行时 Shader 里的单次相位 ,全部由这一套严格归一化的解析参数生成,避免了不同环节拼凑经验相位导致的能量漏算或超支。
管线接入与运行时开销
上面那套积分求根听起来略复杂,但它完全是在 CPU 端预计算好的,GPU 运行时只需要做一次极小规模的查表。
在目前的实现里,我们把参考光学厚度 按对数均匀划分成 49 个采样点,每个点打包存下 4 个不同边界指数 对应的系数 。整张标定表一共只有 49 个 float4,占 784 字节,连纹理都不用建,直接塞进 Constant Buffer 就能用。
只要云层的单次反照率 和水滴粒径分布不变,这张表就是静态复用的。美术在编辑器里拖动密度倍率或边缘过渡宽度时,变化的只是 和 ,Shader 里直接在表上做一维插值即可;只有当反照率或水滴直径发生改变时,才需要让 CPU 重新刷一遍这 49 个点。
落实到 Raymarching 循环里,每个步进采样点的核心代码非常短(这里略去了极小光学厚度下的除零保护和查表边界 clamp):
float rho = sigmaT / sigmaReference;
float tauReference = sigmaReference * transitionWidth;
float c = SampleCalibration(tauReference, boundaryExponent);
float q = c * rho;

float localT = exp(-q);
float gain = albedo * (1.0 - localT)
           / (1.0 - albedo + albedo * localT);

float single = phase * exp(-sunOpticalDepth);
float multiple = gain * INV_FOUR_PI
               * exp(-transportRatio * sunOpticalDepth);
float source = single + multiple;
代码里的 transportRatio 就是前面说的 。算出来的 source 随后乘上太阳辐照度、反照率以及当前步进段的积分权重,直接走原有的透射率累积流程。
和原本共用 exp(-sunOpticalDepth) 的局部方案相比,我们在主循环里其实只多做了一次 exp、一次乘法,外加一次 Constant Buffer 的线性插值(如果把 c 提到步进循环外面按云层参数预取,连每次步进的插值都能省掉)。没有任何新增的 3D 纹理采样,也没有多跑哪怕一步 Light March。
实机效果与局限性
最后放一下实机渲染的对比。
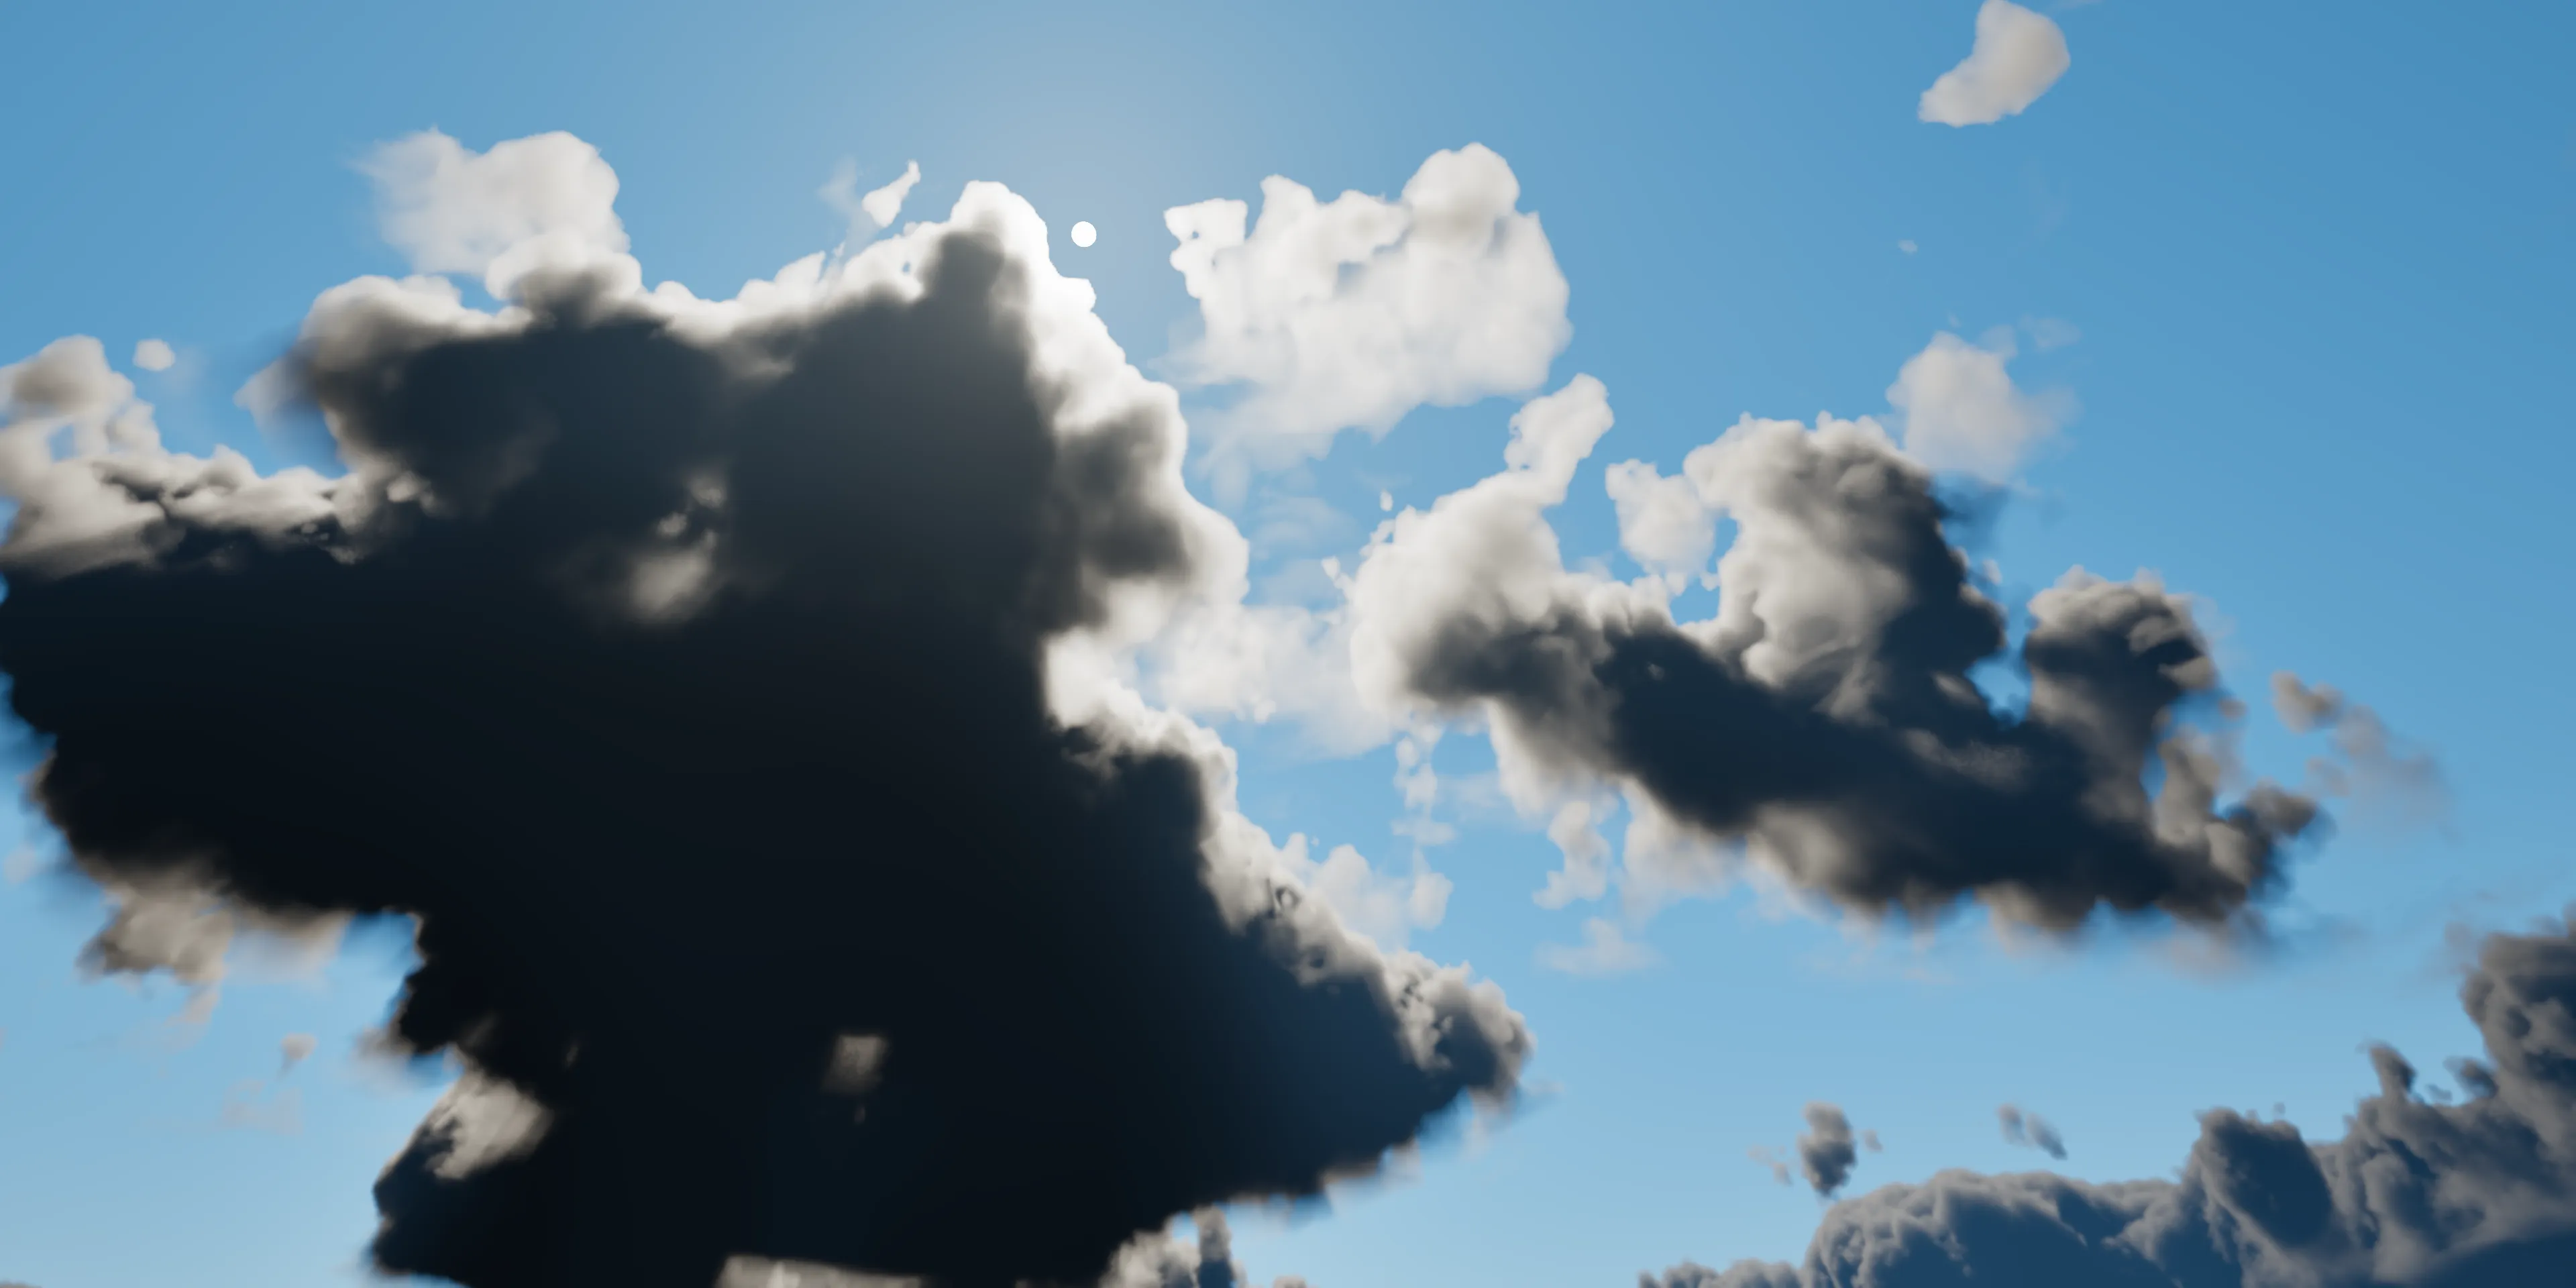
图 5 仅开启单次散射的基准画面,云体内部和背光侧非常暗。
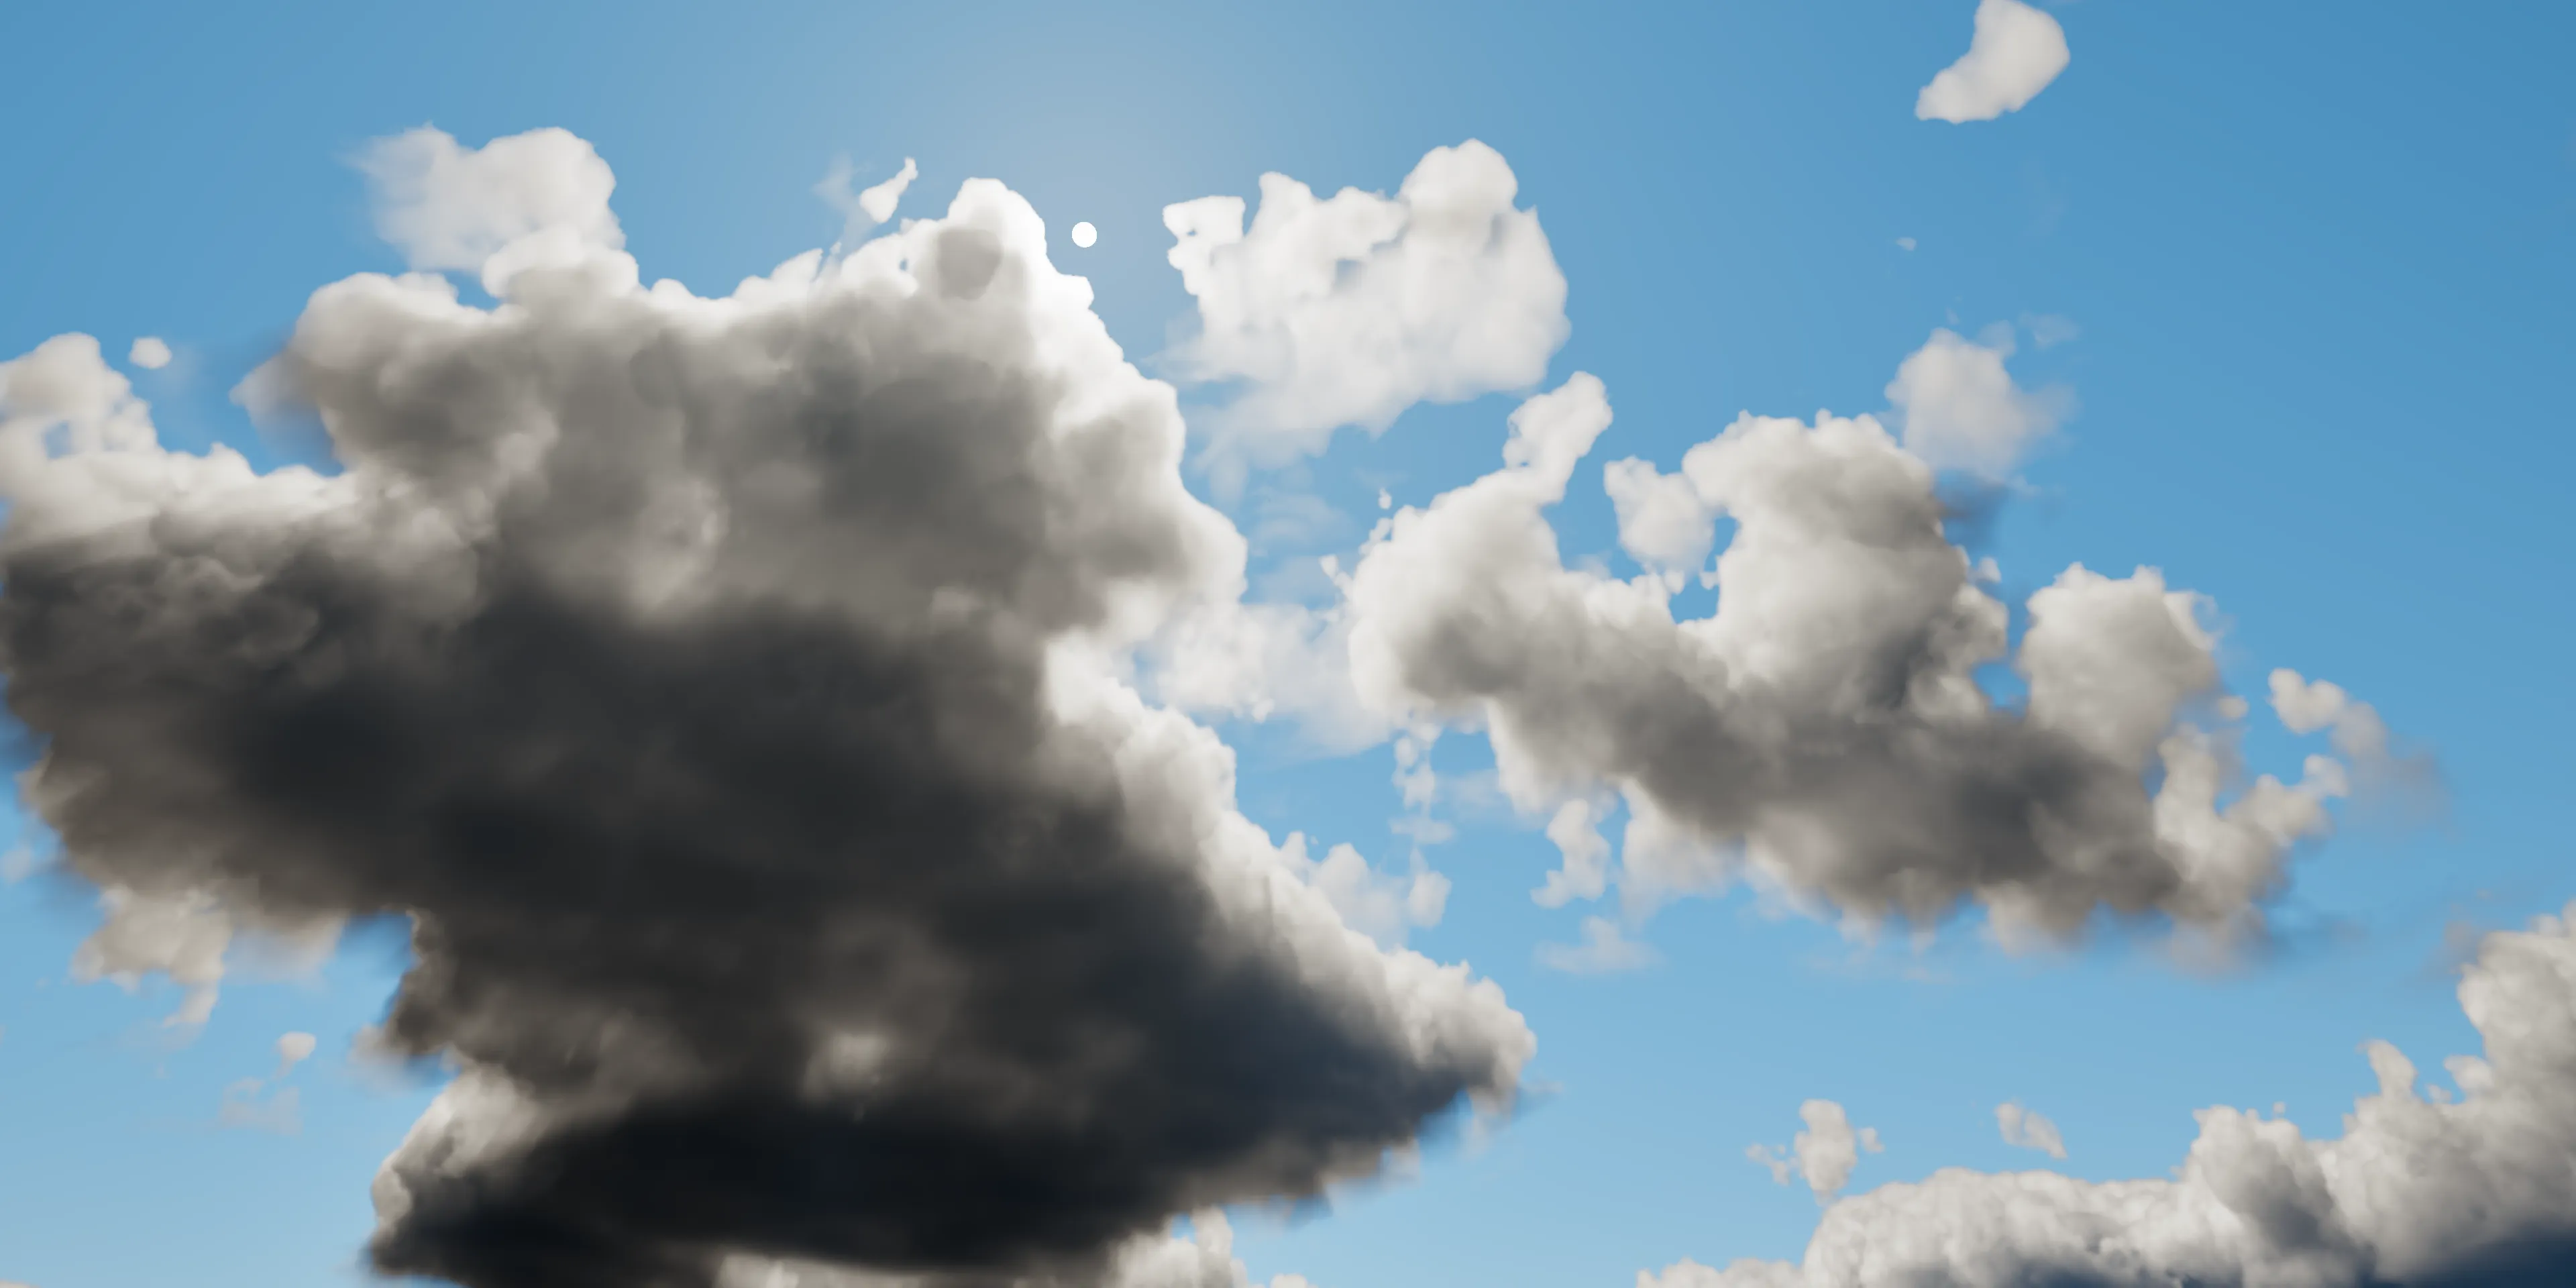
图 6 加入能量标定与分离包络后的局部多重散射效果。内部明暗过渡自然拉开了,同时薄云边缘依然保留了压暗的体积感。
除了肉眼看图,我们也可以把图 3 里那组捕获光路的具体数值拉出来对比一下。在 、、参考光学厚度 的配置下,如果强行用单次衰减包络去标定,求出来的局部系数 大约是 ;换用分离的约化消光包络重标定后, 降到了 。沿着向光步进方向看不同深度处的局部多次散射源项(未乘太阳辐照度与视线权重):
| 太阳光学厚度 | 共用单次衰减的局部多次项 | 分离包络并重标定后 |
|---|---|---|
| 0.190 | 0.000898 | 0.000776 |
| 2.151 | 0.001109 | 0.005308 |
| 6.089 | 0.0000611 | 0.009086 |
| 13.684 | 0.000000110 | 0.012018 |
数据表现得非常直观:在最表层(),新方案的局部贡献稍微收了一点,避免了迎光面过曝;而一旦往云里走深( 到 以上),原本因为 截断而几乎归零的高阶散射被重新释放了出来,能量被真正匀到了云肚子里面。
我们也对标定求解器的数值稳定性做过一轮遍历测试:覆盖 5 组水滴直径、7 档反照率、49 个参考厚度以及 4 个边界指数,总共 6860 组参数组合。标定积分算出的反射率与双流模型目标值之间的最大绝对误差只有 (约 0.084 个百分点)。当然,这个误差只代表一维积分求根的数值精度,不代表它和三维蒙特卡洛路径追踪之间的真实渲染误差。
说到底,这个方案本质上还是一个单点局部近似,它的天花板也是很清楚的:
- 它依然只靠当前点的密度 和全局过渡带参数来盲猜周围邻域,并不知道三维空间里真实的云块长什么样。
- 像复杂云体凹陷处的互相照亮(Inter-reflection)、破碎云块之间的光传输、以及极薄云丝在逆光下的透射细节,这种纯局部模型是无能为力的,还是得靠更真实的空间光照缓存或长步距采样来补。
但如果你手头已经有一套跑通了密度采样、视线步进和太阳向光步进的实时体积云系统,不想大动干戈去加 Pass,那这套改动算是一个性价比很高的补丁。它保留了局部几何级数自带暗边和极低开销的优点,同时用双流参考层管住了高密度区的能量上限,再用约化消光包络把光送进了云体深处。至少在美术反复折腾云形和密度参数的时候,不用再提心吊胆地每次去手调那个多重散射半径了。
参考资料
- 窝的舔,《一个简单的体积云多重散射近似方法》(2022):本文的直接起点,给出了局部传递因子、经验半径与几何级数求和的思路。
- Hillaire, A Scalable and Production Ready Sky and Atmosphere Rendering Technique (2020)(作者版 PDF):知乎原文所借鉴的高阶散射无穷级数闭式求和,见第 5.5 节。
- Jendersie & d’Eon, An Approximate Mie Scattering Function for Fog and Cloud Rendering (2023):本文使用的水滴米氏散射相位拟合及归一化模型。
- Hébert & Becker, Correspondence between continuous and discrete two-flux models (2008):双流模型、有限层反射与透射公式的数学推导背景。
- Pharr, Jakob, & Humphreys, Physically Based Rendering: From Theory to Implementation (3rd ed.), Section 15.5:扩散近似中的约化散射系数与约化消光系数。